Was ist ein LLM-Wiki?
Von Philipp Kant 5 Min. Lesezeit
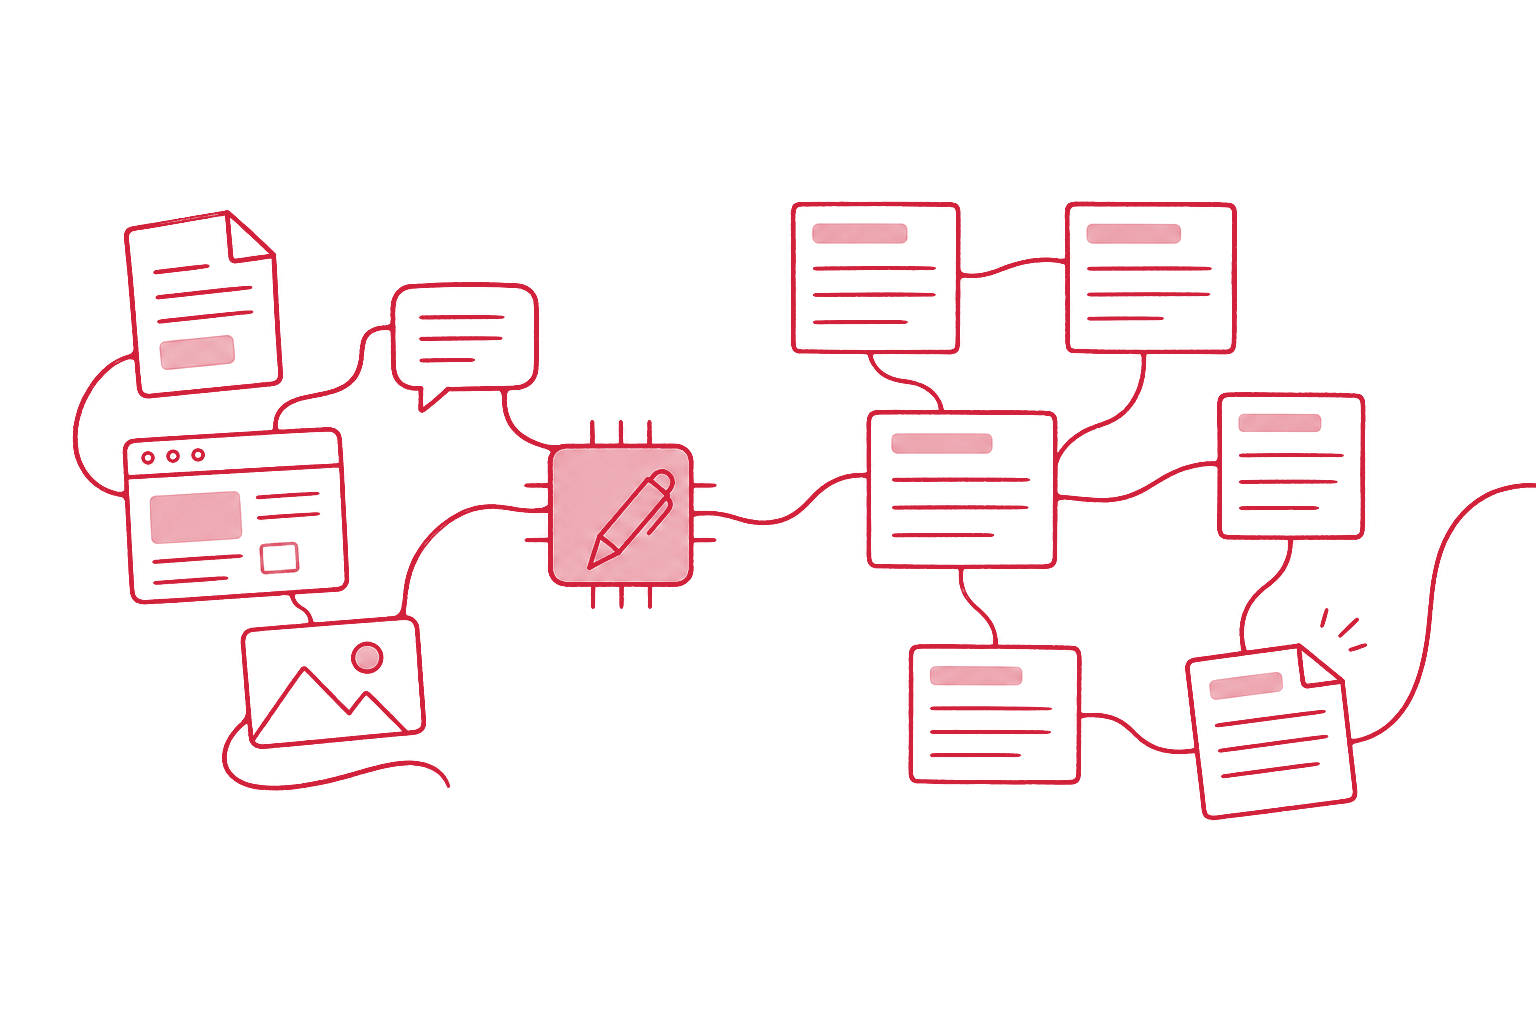
Ein LLM-Wiki ist eine Wissensbasis aus verlinkten Markdown-Seiten, die ein Sprachmodell aus einer Sammlung von Rohquellen schreibt und pflegt, statt diese Quellen für jede Frage neu zu durchsuchen. Andrej Karpathy hat das Muster im April 2026 in einer „Idea File“ beschrieben: einer Seite Beschreibung, die man einem Coding-Agenten übergibt, der das System dann baut.
Sein Kerngedanke in einem Satz aus dieser Datei: Das Wiki ist ein „dauerhaftes, sich aufschichtendes Artefakt“. Jede neue Quelle wird in bestehende Seiten eingearbeitet, Widersprüche werden einmal aufgelöst, und die nächste Frage beginnt bei dieser Arbeit statt bei den Rohdokumenten.
Drei Ebenen: Quellen, Wiki, Schema
| Ebene | Was sie ist | Wer sie schreibt |
|---|---|---|
| Rohquellen | Artikel, Papers, PDFs, Bilder, Datendateien. Die Quelle der Wahrheit, nie bearbeitet | Menschen sammeln sie |
| Das Wiki | Zusammenfassungen, eine Seite pro Entität und Konzept, Vergleiche, ein Überblick, alles verlinkt | Allein das Modell |
| Das Schema | Eine Datei wie AGENTS.md, die Struktur, Konventionen und Abläufe festlegt |
Mensch und Modell gemeinsam |
Zwei Dateien halten das Wiki übersichtlich. index.md ist ein Katalog
aller Seiten nach Kategorie, aktualisiert bei jedem Einlesen. log.md ist
ein Protokoll, an das nur angehängt wird: was wann passiert ist. Karpathy
liest das Ergebnis in Obsidian, das die Links als Graph zeigt, und
versioniert es mit Git.
Drei Vorgänge: Einlesen, Fragen, Lint
- Einlesen (Ingest). Eine Quelle kommt dazu. Das Modell fasst sie zusammen, bespricht die Kernpunkte, aktualisiert den Index, überarbeitet jede Entitäts- und Konzeptseite, die die Quelle berührt, und ergänzt das Protokoll. Laut Karpathy kann eine Quelle 10 bis 15 Seiten berühren; er liest lieber eine Quelle nach der anderen ein.
- Fragen (Query). Das Modell liest den Index, öffnet die passenden Seiten und antwortet mit Verweisen darauf. Eine gute Antwort kann als neue Seite ins Wiki zurückfließen, sodass Fragen das Wiki besser machen.
- Lint. Eine regelmäßige Prüfung: Widersprüche, veraltete Aussagen, verwaiste Seiten, erwähnte Konzepte ohne eigene Seite, fehlende Querverweise, Lücken in den Daten.
In der Größe, die Karpathy beschreibt, etwa 100 Quellen und einige hundert Seiten, reicht die Indexdatei zum Finden aus; Embeddings oder eine Vektordatenbank braucht es nicht. Darüber verweist er auf lokale Suchwerkzeuge.
LLM-Wiki oder RAG
Retrieval-Augmented Generation (was RAG ist) durchsucht die Rohdokumente in dem Moment, in dem eine Frage kommt, und gibt die besten Passagen an das Modell. Ein LLM-Wiki erledigt das Lesen vorab. Beide antworten aus Ihren eigenen Inhalten; sie passen zu unterschiedlichen Lagen.
| LLM-Wiki | RAG | |
|---|---|---|
| Die Arbeit passiert | Wenn eine Quelle kommt | Wenn eine Frage kommt |
| Passende Größe | Bis zu einigen hundert kuratierten Quellen | Tausende bis Millionen Dokumente |
| Antworten stammen aus | Seiten, die das Modell schon zusammengeführt hat | Passagen aus den Originalen |
| Stärke | Zusammenhänge über Quellen, aufgelöste Widersprüche | Aktuelle Daten, exakte Zitate, riesige Bestände |
| Für Menschen lesbar | Ja, es ist ein Wiki | Nicht direkt, es ist ein Index |
| Hauptrisiko | Fehler pflanzen sich in wiederverwendeten Seiten fort | Fehlender Kontext, wenn die Suche die falschen Passagen trifft |
| Berechtigungen | Gemischte Quellen landen auf gemeinsamen Seiten | Pro Dokument zum Zeitpunkt der Frage geprüft |
Die letzte Zeile entscheidet die meisten Fälle im Unternehmen. Ein RAG-System kann prüfen, wer fragt, und nur Dokumente abrufen, die diese Person sehen darf. Ein kompiliertes Wiki führt Quellen auf gemeinsamen Seiten zusammen, und eine Zusammenfassung kann preisgeben, was ein einzelnes Dokument unter Verschluss gehalten hätte. Also ein Wiki pro Zielgruppe, oder RAG dort, wo die Zugriffsrechte variieren.
Wie ein LLM-Wiki im Unternehmen aussieht
Karpathy nennt Firmen-Wikis ausdrücklich als Anwendungsfall. Das Muster passt, wo ein Team immer wieder dieselben Fragen an einen langsam wachsenden Stapel Dokumente stellt:
- Produktwissen. Datenblätter, Zertifikate und Lieferanten-PDFs, zusammengeführt zu einer Seite pro Produktfamilie, Widersprüche zwischen Versionen vom Lint markiert.
- Support. Gelöste Tickets und Handbücher als Antwortseiten, die das Support-Team, und ein Support-Agent, zuerst lesen.
- Einarbeitung. Prozessdokumente, Entscheidungen und Besprechungsnotizen als Wiki, in dem neue Kollegen stöbern und Fragen stellen.
Vier Regeln machen es sicher:
- Die Quellen bleiben unangetastet. Das Modell darf das Wiki schreiben, nie die Originale. Jede Seite verlinkt die Quellen, aus denen sie stammt.
- Lint nach Plan, Review durch einen Menschen. Fehler im Wiki werden weiterverwendet. Die Prüfung findet sie; entscheiden muss jemand, der das Fachgebiet kennt.
- Das Protokoll ist der Prüfpfad. Was kam herein, was wurde geändert, wann. Diese Aufzeichnung macht das Wiki auch Monate später vertrauenswürdig.
- Kennzeichnen, wer eine Seite geschrieben hat. Ein Feld wie
author: humanmacht eine Seite für das Modell tabu: lesen und verlinken ja, umschreiben nie. Seiten mitauthor: agentdarf das Modell überarbeiten, und ein Mensch übernimmt sie nach Prüfung. Ohne diese Trennung klingt ein Wiki aus Agentenhand bald austauschbar, und eines aus Menschenhand veraltet.
FAQ
Wer hat das LLM-Wiki erfunden?
Andrej Karpathy, früher Director of AI bei Tesla und Gründungsmitglied von
OpenAI, hat es im April 2026 beschrieben, zuerst in einem Post auf X mit
dem Titel „LLM Knowledge Bases“, dann in einem GitHub-Gist namens
llm-wiki.
Ist ein LLM-Wiki dasselbe wie ein Second Brain? Ähnliches Ziel, anderer Autor. In einem Second Brain schreibt ein Mensch die Notizen. In einem LLM-Wiki schreibt sie das Modell, und der Mensch kuratiert Quellen und Regeln.
Brauche ich für ein LLM-Wiki eine Vektordatenbank? Bei einigen hundert Seiten nicht; eine Indexdatei reicht. Größere Wikis bekommen eine Suche, und ab da sieht das Ganze aus wie RAG über das Wiki.
Welche Werkzeuge braucht es? Einen Coding-Agenten, der Dateien lesen und schreiben kann (Claude Code, Codex oder ähnliche), einen Ordner mit Markdown, optional Obsidian zum Lesen und Git für die Versionsgeschichte. Die Idea File enthält keinen Code; den Rest baut der Agent.
Kann ein LLM-Wiki RAG ersetzen? Für eine kuratierte Wissensbasis, die sich langsam ändert, oft ja. Für große, schnell wechselnde Dokumentbestände mit Rechten pro Nutzer nein. Viele Systeme landen bei beidem: ein Wiki für das zusammengeführte Wissen, Retrieval für den langen Rest.
Wie sich Antworten aus den eigenen Inhalten anfühlen, zeigt die kostenlose Demo Chat With Your Website, die einen Suchindex Ihrer Website im Moment aufbaut. Wissensbasen auf Firmendokumenten, als Wiki oder RAG und mit den nötigen Zugriffsrechten, bauen wir im Rahmen der KI-Integration.
Diesen Artikel mit einer KI besprechen
